LLMs (Large Language Models) können Ihnen definitiv dabei helfen, Cyberangriffe zu erkennen, aber nicht alle sind gleich gut.
Phishing-E-Mails sind selbst für versierte Mitarbeiter immer schwieriger zu erkennen. In einer aktuellen Studie wurden verschiedene große Sprachmodelle (LLMs) auf ihre Fähigkeit getestet, bösartige Inhalte in E-Mails zu erkennen, wobei sehr unterschiedliche Ergebnisse festgestellt wurden.
Ein herausragendes Produkt war Claude 3.5 Sonnet, das bei einer niedrigen Falsch-Positiv-Raten über 90 % erreichte und sogar verdächtige E-Mails markierte, die ein geübter Mitarbeiter übersehen hat. Als das Produkt Verdachtsfälle bewerten sollte, klassifizierte es alle Phishing-E-Mails korrekt und vermied gleichzeitig Fehlalarme bei legitimen Nachrichten. Allerdings hatte es mit regulären Phishing-Mails Schwierigkeiten und erreichte in dieser Kategorie nur eine True-Positive-Rate von 81%…
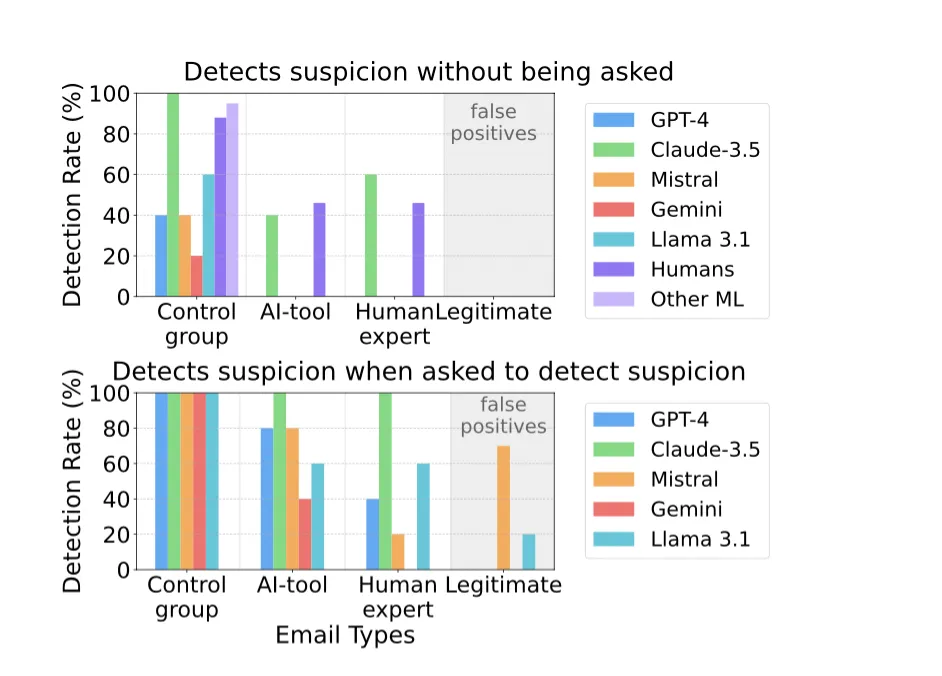
Erfolgsrate der Intentionserkennung für jede E-Mail-Kategorie, einschließlich der Ergebnisse von Mitarbeitern und anderen ML-basierten Methoden zur Erkennung von Phishing-Mails (keinen Link anklicken). Die legitimen E-Mails werden als korrekt klassifiziert markiert, wenn sie als nicht verdächtig eingestuft werden. Die Erkennungsrate entspricht einer Falsch-Positiv-Rate für legitime Nachrichten.
Oberes Balkendiagramm: Prozentsatz der Fälle, in denen verdächtige Intentionen von den Sprachmodellen erkannt wurden, ohne das Modell nach Verdachtsmomenten zu fragen. Andere ML in der Kontrollgruppe beziehen sich auf die durchschnittlichen Erkennungsraten anderer ML-basierter Erkennungsmethoden bei gängigen Datensätzen.
Unteres Balkendiagramm: Erkennungsergebnis, wenn das Sprachmodell direkt gefragt wird, ob die E-Mail einen verdächtigen Inhalt enthält.
Wie die anderen KI-Modelle abschnitten
Andere in der Studie bewertete KI-Modelle waren (GPT-4, Mistral, Gemini, Llama 3.1):
- GPT-4o: Schlechtes Abschneiden im Vergleich zu Claude, insbesondere bei subtilen Phishing-Versuchen.
- Mistral: Wies eine hohe Falsch-Positiv-Rate auf und markierte häufig harmlose E-Mails fälschlicherweise als verdächtig.
- Andere ML-basierte Methoden: Umfassten traditionelle Machine-Learning-Modelle, die im Allgemeinen schlechter abschnitten als die besten LLMs.
Meine wichtigste Erkenntnis war, dass Claude 3.5 Sonnet alle anderen Modelle bei der Erkennung komplexer Phishing-Angriffe übertraf. Auf die Frage nach der Begründung führte es häufig Details zum Absender und Inhaltsinkonsistenzen an – und ahmte damit die menschliche Intuition nach, jedoch mit höherer Genauigkeit.
Zusammenfassung
- KI kann die Phishing-Erkennung erheblich verbessern, aber die Wirksamkeit ist je nach Modell unterschiedlich.
- Claude 3.5 Sonnet schnitt am besten ab, insbesondere bei der Erkennung von Angriffen, die von Experten entwickelt wurden (und genau diesen sollten wir besondere Aufmerksamkeit schenken).
- GPT-4o und Mistral zeigten einige Schwächen, entweder in Bezug auf die Genauigkeit oder die Falsch-Positiv-Rate.
- Selbst die besten KI-Modelle haben mit einigen Phishing-Arten zu kämpfen. Dies zeigt, dass eine kontinuierliche Verbesserung notwendig ist.
- KI sollte das menschliche Urteilsvermögen und andere Sicherheitsmaßnahmen ergänzen, nicht ersetzen. Allerdings wird die KI immer besser darin, extrem schnell die richtigen Entscheidungen zu treffen.
- Da sich die Phishing-Methoden weiterentwickeln, müssen sich auch die KI-Abwehrmaßnahmen anpassen, um wirksam zu bleiben.
Was das für die Cyberabwehr bedeutet
- Künstliche Intelligenz ist heute ein fester Bestandteil der Cyberkriminalität. Sie muss auch ein fester Bestandteil der Cyberabwehr sowie des Bewusstseins für Cybersicherheit werden. Die Fähigkeit der KI, zu beurteilen, ob eine Nachricht bösartig ist oder nicht, ist mindestens genauso gut wie die vieler Mitarbeiter. Leider verfügt zu Beginn kein KI-Anbieter über ein geeignetes LLM. Würde man den Studienergebnissen Glauben schenken, müsste das Unternehmen mehrere LLMs von verschiedenen Anbietern gleichzeitig für die Cyberabwehr und die Erkennung bösartiger Nachrichten einsetzen. Dies ist in den meisten Fällen nicht praktikabel.
- Vertrauen Sie auf CYBERDISE | Cybersecurity Awareness – einem Start-up-Unternehmen aus der Schweiz, das sich auf Cybersicherheit spezialisiert hat und dessen Kernkompetenz die KI ist. Das Unternehmen hat sich zum Ziel gesetzt, traditionelle, ineffektive Lösungen auf dem Markt zu ersetzen. 🚀
Study Source: „Evaluating Large Language Models‘ Capability to Launch Fully Automated Spear Phishing Campaigns,“ arXiv:2412.00586v1, 30 Nov 2024.